Üç Ders 2024 20 soru

İstatistik Analiz 2024 Üç Ders

Kaynak: https://lolonolo.com/2026/05/16/istatistik-analiz-2024-uc-ders-sorulari/

📖 Konu özeti (sınav öncesi tekrar)

İstatistik Analiz 2024 Üç Ders Soruları

İstatistik Analiz 2024 Üç Ders Soruları

Parametrik ve Non-Parametrik Testler | Regresyon ve Korelasyon Analizi | Örnekleme Yöntemleri ve Standart Hata | Hipotez Testi Adımları ve Parametreler

Hipotez Testleri Varsayımları ve Non-Parametrik Alternatifler

İstatistikte iki bağımsız grubun ortalamalarını karşılaştırmak için normal şartlarda parametrik bir test olan “bağımsız iki örneklem t-testi” uygulanır. Ancak verilerin normal dağılım göstermemesi veya varyansların homojen olmaması gibi parametrik varsayımlar ihlal edildiğinde, bu testin non-parametrik (parametrik olmayan) birebir karşılığı olan Mann-Whitney U testi tercih edilir. Benzer şekilde, bağımlı iki grup için Wilcoxon, bağımsız k grup için Kruskal-Wallis ve bağımlı k grup için Friedman testleri non-parametrik alternatiflerdir. Nitel verilerin analizinde kullanılan Khi-kare bağımsızlık testi ise, kontenjans tablosunda yer alan gözlenen ve beklenen frekanslar arasındaki farkların karesini temel alarak değişkenler arasında bir ilişki olup olmadığını test eder.

Regresyon Modelleri, Korelasyon ve Belirginlik Katsayısı

Basit doğrusal regresyon modelleri Y = a + bX matematiksel formuyla tahmin edilir; burada a sabit terimi (intercept), b ise eğim katsayısını temsil eder. Y = 4,3 + 9,9X şeklinde tahmin edilen bir modelde, bağımsız değişken (X) sıfır (0) olduğunda bağımlı değişkenin (Y) alacağı değer doğrudan sabit terim olan 4,3’e eşit olur. Modelin açıklayıcılık gücünü gösteren belirginlik katsayısı (R^2) ile açıklanamayan kısmı gösteren belirsizlik katsayısının toplamı her zaman 1’e eşittir. Bu nedenle R^2 = 0,88 olan bir modelde, belirsizlik katsayısı 1 – 0,88 = 0,12 olarak hesaplanır. İki değişken arasındaki doğrusal ilişkinin yönünü ve şiddetini gösteren basit doğrusal korelasyon katsayısı (r) ise, belirginlik katsayısının karekökü alınarak (\sqrt{R^2}) veya kovaryansın standart sapmalar çarpımına bölünmesiyle hesaplanır ve R^2 = 0,6944 ise r = \sqrt{0,6944} = 0,8333 olarak bulunur.

Örnekleme Teorisi, Örnekleme Yöntemleri ve Standart Hata

Devesa bir ana kütleden onu temsil edecek bir alt küme çekerek ana kütle parametrelerini tahmin etme işlemine Örnekleme (Sampling) adı verilir. Ana kütlenin genel olarak heterojen (farklı) göründüğü ancak kendi içinde homojen (türdeş) alt zümreler barındırdığı biliniyorsa, her alt gruptan ağırlığı oranında tesadüfi seçim yapılmasını sağlayan Tabakalı (Zümrelere Göre) Örnekleme yöntemi kullanılır. Veri toplama yöntemleri arasında kağıt ve kalemle yapılan yüz yüze anket uygulaması; anketör ücretleri, lojistik, basım ve zaman maliyetleri nedeniyle en yüksek maliyetli yöntemdir. Ana kütle standart sapması (\sigma) bilindiğinde ortalamanın standart hatası (SE), ana kütle standart sapmasının örnek birim sayısının kareköküne (\sigma / \sqrt{n}) bölünmesiyle hesaplanır. Örneğin; \sigma = 35,75 ve n = 121 ise SE = 35,75 / \sqrt{121} = 35,75 / 11 = 3,25 olur. Örnek standart sapması (s) kullanıldığında ise s = 18 ve n = 25 için SE = 18 / \sqrt{25} = 18 / 5 = 3,60 hesaplanır. Mümkün olan tüm örneklerin ortalamalarıyla oluşturulan olasılık modeline ise örnek ortalamaları teorik dağılımı denir.

Güven Aralıkları, t Dağılımı ve Hipotez Adımları

Ana kütleyi karakterize eden ölçülere Parametre (\mu, \sigma), örneklemden elde edilenlere ise istatistik (\overline{x}, s) denir. Ana kütle varyansı bilinmediğinde ve örnek hacmi küçük olduğunda (n < 30), verilerin n-1 serbestlik dereceli Student (t) dağılımına uyduğu kabul edilir; serbestlik derecesi 15 ve \alpha = 0,1 iken tablodan okunan kritik t değeri 1,753’tür. Güven aralıklarında anlamlılık düzeyi (\alpha) doğrudan hata payını veya parametrenin güven sınırları dışında bulunması olasılığını ifade eder (\alpha = 0,02 ise bu olasılık doğrudan 0,02’dir). Hata payı (\alpha) büyüdükçe güven düzeyi düşeceği için en dar aralık tahmini en yüksek \alpha değerinde (Örn: \alpha = 0,15) gerçekleşir. Hipotez testlerinde “farklıdır” (\neq) iddiası yön belirtmediği için çift taraflı (çift kuyruklu) test kurulmasını zorunlu kılar. Beş adımdan oluşan hipotez testlerinin en son adımını ise matematiksel kararın sözel ifadelere döküldüğü “Test sonucunun yorumlanması” adımı oluşturur.

İstatistik Analiz 2024 Üç Ders Soruları

İstatistik Analiz 2024 Üç Ders Soruları
20 soru
Şıkka dokun, anında açıklamasını gör — ya da çalışma modunda tüm cevapları aç.
Soru 1
Khi-kare bağımsızlık testinin test istatistiği, kontenjans tablosunda yer alan ….. arasındaki farkları temel alır.
Yukarıdaki cümlede boş bırakılan yere aşağıdakilerden hangisi getirilmelidir?
ADoğru cevap
Açıklama
Khi-kare bağımsızlık testinde, kontenjans tablosundaki gözlenen (gerçek) frekanslar ile beklenen (teorik) frekanslar arasındaki farklar hesaplanır. Bu farkların büyüklüğü test istatistiğini oluşturur ve değişkenler arasında ilişki olup olmadığını anlamamızı sağlar.
Soru 2
Parametrik test varsayımları ihlal edildiğinde “iki ortalama arasındaki farkın önemlilik testi” yerine kullanılması önerilen, parametrik olmayan hipotez testi aşağıdakilerden hangisidir?
BDoğru cevap
Açıklama
İki bağımsız grubun nicel ölçümlerine ait ortalamalar karşılaştırılırken normal şartlar altında parametrik bir yöntem olan “bağımsız iki örneklem t-testi” uygulanır. Ancak verilerin normal dağılım göstermemesi, varyansların homojen olmaması veya örneklem hacminin çok küçük olması gibi parametrik test varsayımlarının ihlal edildiği durumlarda bu testin yerine geçebilecek güvenilir bir alternatif aranır. İki bağımsız grup ortalaması arasındaki farkın önemlilik testinin parametrik olmayan (non-parametrik) birebir karşılığı “Mann-Whitney U testi”dir. Bu test, verilerin ham değerleri yerine sıralama puanlarını (rank) kullanarak grupların dağılımlarının veya medyanlarının birbirinden farklı olup olmadığını test eder. Diğer şıklarda yer alan Wilcoxon testi bağımlı (eşleştirilmiş) iki grup için, Kruskal-Wallis bağımsız k grup için, Friedman ise bağımlı k grup için tercih edilen non-parametrik yöntemlerdir.
Soru 3
Ana kütle standart sapmasının 35,75 ve örnek birim sayısının 121 olması durumunda ortalamanın standart hatası aşağıdakilerden hangisidir?
BDoğru cevap
Soru 4
Örnek kütle dağılma ölçüsü olan s değerinin 18 ve örnek birim sayısının 25 olması durumunda ortalamanın standart hatası aşağıdakilerden hangisidir?
BDoğru cevap
Soru 5
Aralarında ilişki olduğu düşünülen iki değişken arasında hesaplanan doğrusal regresyon modeli,
Y^i​=4,3+9,9Xi​
biçiminde tahmin edilmiştir.
Buna göre bağımsız değişkenin değeri sıfır olduğunda bağımlı değişkenin alacağı değer aşağıdakilerden hangisidir?
CDoğru cevap
Açıklama
Basit doğrusal regresyon denklemleri genel olarak Y = a + bX matematiksel formuyla ifade edilir. Bu model yapısı içerisinde Y bağımlı değişkeni, X bağımsız değişkeni, b eğim katsayısını (bağımsız değişkendeki bir birimlik değişimin bağımlı değişken üzerindeki etkisini) ve a ise regresyon doğrusunun y eksenini kestiği sabit değeri (intercept) temsil etmektedir. Model üzerinde bağımsız değişken olan X_i yerine sıfır (0) değeri yazıldığında, eğim katsayısı ile çarpım durumu sıfırlanacağı için (9,9 \times 0 = 0) denklemin sağ tarafında yalnızca sabit terim kalacaktır. Tahmin edilen modelde sabit terim 4,3 olduğuna göre, bağımsız değişkenin tamamen etkisiz veya sıfır olduğu bir senaryoda bağımlı değişkenin alacağı başlangıç değeri doğrudan 4,3 olacaktır.
Soru 6
Çok sayıda birim içeren bir ana kütleden örnek çekmek suretiyle hesaplanan örnek istatistiğinden hareketle ana kütle parametresini tahmin etme işlemine ….. denir.
Yukarıdaki cümlede boş bırakılan yere aşağıdakilerden hangisi getirilmelidir?
DDoğru cevap
Açıklama
İstatistiksel analizin ve çıkarımsal istatistiğin en temel süreçlerinden biri, incelenmesi zaman, maliyet veya iş gücü açısından imkansız ya da mantıksız olan devasa büyüklükteki bir ana kütleden (popülasyon), onu en iyi şekilde temsil edebilecek sınırlı sayıda birimden oluşan alt bir grubu seçmektir. Bu alt gruptan (örneklemden) elde edilen istatistikleri (örnek ortalaması, örnek varyansı vb.) kullanarak ana kütlenin bilinmeyen parametreleri (ana kütle ortalaması, varyansı) hakkında bilimsel tahminlerde bulunma, genellemeler yapma ve karar verme sürecinin bütünsel adına “Örnekleme” (Sampling) denir. Örnekleme, anakütle hakkında pratik, hızlı ve bilimsel bir şekilde bilgi üretmenin yegane yoludur.
Soru 7
Basit regresyon modelinde belirginlik katsayısı 0,88 bulunmuştur. Buna göre belirsizlik katsayısının değeri nedir?
ADoğru cevap
Açıklama
Belirginlik katsayısı (R²), modelin açıklayabildiği varyans oranını gösterir. Basit regresyonda belirsizlik katsayısı ise açıklanamayan kısmı ifade eder ve 1’den R² çıkarılarak bulunur.
R² = 0,88 verildiğine göre:
Belirsizlik katsayısı = 1 − 0,88 = 0,12
Sonuç olarak belirsizlik katsayısı 0,12’dir..
Soru 8
Ana kütle varyansının bilinmediği ve örnek birim sayısının otuzdan az olması (küçük örnek) durumunda örnek ortalamaları teorik dağılımın şeklinin ….. serbestlik dereceli student (t) dağılımına uyduğu kabul edilmektedir.
Yukarıdaki cümlede boş bırakılan yere aşağıdakilerden hangisi getirilmelidir?
CDoğru cevap
Açıklama
Örneklem istatistiklerinden hareketle tahmin yürütürken veya hipotez testi yaparken örnek hacmi (n) ve ana kütle varyansının durumu kritik öneme sahiptir. Eğer ana kütle varyansı (\sigma^2) bilinmiyorsa ve veri toplama sürecinde ulaşılan örnek birim sayısı otuzdan küçükse (n < 30), verilerin dağılımı için standart normal dağılım (Z) yerine “Student’s t dağılımı” baz alınır. t dağılımı, şekil olarak normal dağılıma benzemekle birlikte basıklığı ve yaygınlığı serbestlik derecesine (degrees of freedom) bağlı olarak değişen bir eğridir. Tek grup veya tek örneklem durumlarında, örnek ortalaması hesaplanırken bir serbestlik kısıtı ortaya çıktığı için serbestlik derecesi toplam birim sayısının bir eksiği, yani “n-1” olarak formüle edilir. Örneklem büyüklüğü arttıkça t dağılımı kademeli olarak standart normal dağılıma yakınsar.
Soru 9
Bir örnekleme çalışmasıyla örnek ortalaması 4,2 ve örnek dağılma ölçüsü 1,8 hesaplanmıştır. Anakütle ortalaması için aralık tahmini yapılması halinde en dar aralık tahmini aşağıda verilen α değerlerinden hangisi için söz konusudur?
CDoğru cevap
Açıklama
İstatistikte aralık tahmini (güven aralığı), bilinmeyen bir ana kütle parametresinin belirli bir olasılıkla hangi değerler arasında yer alacağını gösteren bir sınır belirleme işlemidir. Güven aralığının genişliği, anlamlılık düzeyi (α) veya bir diğer ifadeyle hata payı ile doğrudan ilişkilidir. Güven düzeyi (1 – α) arttıkça (yani hata yapma ihtimalimizi düşürmek istediğimizde), aralığı geniş tutmak zorunda kalırız; bu da tahminin hassasiyetini azaltır. Tam tersi durumda, hata payı olan α değerini ne kadar yüksek tutarsak (güven düzeyini ne kadar düşürürsek), aralık o kadar daralır. Seçeneklerde verilen α değerleri incelendiğinde; 0,15 değeri en yüksek hata payını, dolayısıyla en düşük güven düzeyini (yüzde 85) temsil eder. En düşük güven düzeyinde aralık genişliği en minimum boyutuna ulaşacağı için, en dar aralık tahmini α = 0,15 için gerçekleşir.
Soru 10
Serbestlik derecesinin 15 olması durumunda student (t) tablosunda α=0,1 değerine karşılık gelen t standart değeri nedir?
ADoğru cevap
Açıklama
Hipotez testlerinde kritik sınırları belirlemek veya güven aralığı katsayılarını bulmak amacıyla istatistiksel dağılım tablolarından yararlanılır. Student (t) dağılım tablosunda bir değeri okuyabilmek için iki temel parametreye ihtiyaç duyulur: Serbestlik derecesi (sd veya df) ve testin yönüne göre belirlenen anlamlılık düzeyi (\alpha). Soruda serbestlik derecesi 15 ve anlamlılık düzeyi \alpha = 0,1 (yüzde 10) olarak tanımlanmıştır. t tablosunun ilgili sütununda 15 serbestlik derecesi satırı ile 0,1 hata payı sütununun kesiştiği noktaya bakıldığında elde edilen teorik standart t değeri 1,753 olarak okunmaktadır. Bu katsayı, örneklem değerlerinin sınır noktalarını belirlemede çarpan olarak kullanılır.
Soru 11
Ana kütle ortalaması için aralık tahmini yaparken α=0,02 ise, ana kütle ortalamasının güven sınırları dışında bulunması olasılığı nedir?
CDoğru cevap
Açıklama
Aralık tahmininde α (alfa) simgesi, “anlamlılık düzeyi” veya doğrudan “hata payı” anlamına gelir. Güven aralığı oluşturulurken süreç iki parçaya bölünür: Birincisi, tahminimizin doğru olma ve parametrenin bu aralığa düşme olasılığı olan “güven düzeyi” (1 – α); ikincisi ise parametrenin hesaplanan bu aralığın tamamen dışında kalma, yani yanılma olasılığımız olan “hata payı” (α). Soruda hata payı doğrudan \alpha = 0,02 (yüzde 2) olarak verildiğine göre, ana kütle ortalamasının belirlenen bu güven sınırlarının dışında kalma, yani aralığı ıskalama olasılığı doğrudan bu değere eşittir ve 0,02 olarak gerçekleşir. Bu senaryoda güven düzeyimiz ise 1 – 0,02 = 0,98 (yüzde 98) olmaktadır.
Soru 12
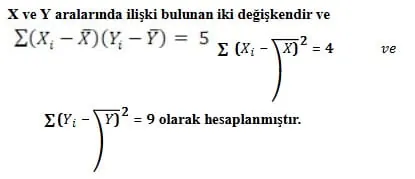
İstatistik Analiz 2024 Üç Ders Soruları 12. soru
Buna göre söz konusu iki değişken arasındaki basit doğrusal korelasyon katsayısı aşağıdakilerden hangisidir?
ADoğru cevap
Soru 13
Aşağıdaki anket uygulama biçimlerinden hangisinin maliyeti en yüksektir? (Anketin uygulanma biçiminin yanıtları değiştirmeyeceği ve aynı topluluğa uygulanacağı varsayılmaktadır.)
DDoğru cevap
Açıklama
Veri toplama aşamasında tercih edilen anket uygulama yöntemleri; lojistik, zaman, personel ve materyal maliyetleri açısından ciddi farklılıklar gösterir. Elektronik posta (B) neredeyse sıfır maliyetlidir; telefon ve bilgisayar destekli aramalar (C, E) belirli bir merkezden hızlıca yürütülür. Posta (A) sadece gönderim maliyeti barındırır. Ancak “Kâğıt ve kalem kullanılarak yapılan yüz yüze anket” (D) yönteminde; anketörlerin saha çalışması için ulaşım ve konaklama giderleri, her bir katılımcı için harcanan uzun zaman, anketörlerin iş gücü ücretleri ve binlerce sayfa formun basım maliyeti söz konusudur. Bu nedenlerden ötürü yüz yüze saha anketleri, lojistik açıdan işletmeye ve araştırmacıya en yüksek maliyet yükünü getiren yöntemdir.
Soru 14
Ana kütlenin genel yapı itibarıyla heterojen göründüğü ancak, barındırdığı alt grupların kendi içinde homojen olduğu durumlarda kullanılacak örnekleme yöntemi aşağıdakilerden hangisidir?
BDoğru cevap
Açıklama
Örnekleme tasarımlarında temel amaç, ana kütleyi en az hata ile yansıtabilmektir. Eğer incelenen ana kütle heterojen (farklı özelliklere sahip birimlerden oluşan karmaşık) bir yapıda ise, basit tesadüfi örnekleme temsil yeteneğini kaybedebilir. Ancak bu heterojen yapının içinde, kendi aralarında benzer özellikler taşıyan (homojen olan) belirli alt zümreler, katmanlar veya tabakalar (örneğin gelir grupları, eğitim düzeyleri, yaş kırılımları) ayırt edilebiliyorsa, en doğru yaklaşım “Zümrelere göre (tabakalı) örnekleme” uygulamaktır. Bu yöntemde ana kütle önce homojen alt gruplara ayrılır, ardından her gruptan ağırlığı oranında tesadüfi seçim yapılır; böylece her alt grubun örneklemde adil bir şekilde temsil edilmesi garanti altına alınır.
Soru 15
Ana kütlenin, incelenen özellik açısından heterojen yapıda bulunması ancak türdeş alt tabakalardan oluştuğunun bilinmesi durumunda, türdeş olan tabakaların her birinden tesadüfi olarak örnek çekilmesi şeklinde uygulanan örnekleme yöntemi aşağıdakilerden hangisidir?
EDoğru cevap
Açıklama
Bu soru, bir önceki sorunun tanımını daha teknik terimlerle pekiştirmektedir. “Türdeş” kelimesi istatistikte homojen yapıyı ifade eder. Ana kütlenin genel olarak değişken ve heterojen olduğunu bilmemize rağmen, onu oluşturan alt katmanların kendi içinde türdeş (homojen) yapılara ayrıldığını saptamışsak, izlenecek en bilimsel olasılıklı örnekleme yöntemi “Tabakalı (Zümrelere Göre) Örnekleme”dir. Her bir türdeş tabakanın (zümrenin) içinden, kendi hacmiyle orantılı olacak şekilde basit tesadüfi yöntemle birimler çekilir. Bu sayede varyans minimize edilerek tahminlerin standart hatası düşürülür ve evreni yansıtma gücü maksimum seviyeye çıkarılır.
Soru 16
I. İstatistik dersinin vize not ortalaması 70’ten fazladır.
II. Bir ailenin aylık gıda harcaması 5000 TL’den azdır.
III. A bölgesinde ilkbahar mevsiminde ortalama sıcaklık en fazla 22 santigrat derecedir.
IV. A ve B istasyonları arasındaki ortalama sefer süresi 10 dakikadan farklıdır.
V. Yeni geliştirilen operasyon sonrasında hastanın taburcu olma süresi 3 günden daha azdır.
Yukarıda verilen iddialar göz önüne alındığında hangi hipotez testinin çift taraflı olarak kurulması gerekir?
DDoğru cevap
Açıklama
Hipotez testlerinde alternatif hipotezin (H_1) kurulma şekli, testin tek kuyruklu (tek taraflı) mı yoksa çift kuyruklu (çift taraflı) mı olacağını belirler. Eğer iddia “fazladır” (>), “azdır” (<), “en fazla” (\le) gibi belirli bir tek yönü, büyüklüğü veya küçüklüğü işaret ediyorsa test tek taraflı kurulur (I, II, III ve V nolu maddeler tek taraflıdır). Ancak iddia “farklıdır” (\neq) ifadesini içeriyorsa, bu durum değerin hedeflenen noktadan daha az da olabileceği daha çok da olabileceği anlamına gelir; yani yön belirtmez, sadece eşit olmama durumuna odaklanır. IV. maddedeki “sefer süresi 10 dakikadan farklıdır” iddiası yön belirtmediği ve sadece eşit olmama (\neq) durumunu sınadığı için hipotezin çift taraflı (çift kuyruklu) olarak kurulmasını zorunlu kılar.
Soru 17
I. Temel ve alternatif hipotezlerin oluşturulması
II. Anlamlılık düzeyinin belirlenmesi ve kritik değerin bulunması
III. Test istatistiği değerinin hesaplanması
IV. Kritik değer ile test istatistiği değerinin karşılaştırılması
V. Test sonucunun yorumlanması
Yukarıdaki aşamalardan hangisi hipotez testinin son adımını oluşturmaktadır?
EDoğru cevap
Açıklama
Bilimsel bir hipotez testi süreci belirli bir mantıksal silsile ve algoritma takip edilerek yürütülür. Bu adımlar sırasıyla şöyledir: İlk olarak temel (H_0) ve alternatif (H_1) hipotezler net olarak ortaya konur (I). İkinci adımda testin güven derecesini belirleyen anlamlılık düzeyi (\alpha) seçilir ve buna uygun kritik tablo değerleri saptanır (II). Üçüncü adımda eldeki örneklem verileri kullanılarak amaca uygun test istatistiği değeri hesaplanır (III). Dördüncü adımda hesaplanan bu test değeri ile kritik sınır değeri karşılaştırılarak reddetme veya reddedememe kararı verilir (IV). Sürecin en son, nihai ve nihai amacını oluşturan beşinci adımı ise; elde edilen bu matematiksel sonucun araştırmanın bağlamına uygun olarak sözel ifadelere dökülmesi, yani “Test sonucunun yorumlanması” ve karara bağlanması adımıdır (V).
Soru 18
Bir anakütleyi başka anakütlelerden ayırt etmeye yarayan ve o anakütleyi niteleyen, karakterize eden ölçülere verilen ad aşağıdakilerden hangisidir?
EDoğru cevap
Açıklama
İstatistikte ölçüler, ait oldukları veri kütlesinin büyüklüğüne ve kapsamına göre iki temel isim alırlar. Çok sayıda birimden oluşan ve araştırmanın evrenini oluşturan ana kütleyi (popülasyonu) bizzat niteleyen, onu karakterize eden, tüm birimler üzerinden hesaplanan sabit özet değerlere (ana kütle ortalaması \mu, ana kütle standart sapması \sigma vb.) “Parametre” adı verilir. Parametreler ana kütleyi diğer evrenlerden ayırt eden kimlik özellikleridir. Önyargısız bir şekilde sadece seçilen küçük bir örneklem grubu üzerinden hesaplanan değerlere ise “İstatistik” (tahmin edici) adı verilir.
Soru 19
Bir ana kütleden çekilmesi mümkün tüm örneklerin çekilip örnek ortalamalarının hesaplanması ve her bir örneğin çekilme olasılığının belirlenerek oluşturulan olasılık dağılımına ….. adı verilir.
Yukarıdaki cümlede boş bırakılan yere aşağıdakilerden hangisi getirilmelidir?
DDoğru cevap
Açıklama
Çıkarımsal istatistiğin kuramsal temelini ve Merkezi Limit Teoremi’ni açıklayan bu kavram, teorik bir olasılık modelidir. Belirli bir büyüklükteki (n) bir ana kütleden, seçilmesi matematiksel olarak mümkün olan tüm aynı büyüklükteki örneklemler tek tek çekilse ve her bir örneklemin kendi ortalaması (\overline{x}) ayrı ayrı hesaplansa; ardından bu elde edilen yüzlerce/binlerce örneklem ortalamasının kendi içindeki frekans ve gerçekleşme olasılıkları incelenerek bir olasılık fonksiyonu oluşturulsa, ortaya çıkan bu özel ve kapsamlı dağılıma “Örnek ortalamalarının teorik dağılımı” (Sampling Distribution of the Mean) adı verilir. Bu teorik dağılım, örnek ortalamalarının ana kütle parametresi etrafında nasıl kümelendiğini görmemizi sağlayan matematiksel bir temeldir.
Soru 20
Ana kütle varyansının bilinmesi durumunda, ortalamanın standart hatası …../….. bölünmesiyle hesaplanmaktadır.
Yukarıdaki cümlede boş bırakılan yerlere sırasıyla aşağıdakilerden hangisi getirilmelidir?
EDoğru cevap