Ara Sınav (Vize) 2024-2025 20 soru

Makine Öğrenmesi 2024-2025 Ara Sınav (Vize)

Kaynak: https://lolonolo.com/2026/03/08/makine-ogrenmesi-2024-2025-vize-sorulari-bahar/

📖 Konu özeti (sınav öncesi tekrar)

Makine Öğrenmesi 2024-2025 Vize Soruları (Bahar)

Makine Öğrenmesi 2024-2025 Vize Soruları (Bahar)

Veri Bilimi ve Veri Tiplerine Giriş

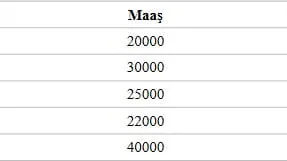
Makine öğrenmesi süreçlerinin en temel basamağı veriyi doğru tanımlamaktır. Veriler; sayısal (ayrık ve sürekli) ve kategorik (nominal ve ordinal) olarak ayrılır. Örneğin, çağrı merkezine gelen aramaların sayısı tam sayılarla ifade edildiği için ayrık veri tipindedir. Kategorik verilerde ise “Küçük – Orta – Büyük” gibi derecelendirme içeren gruplar sıralı (ordinal) kategorik verilere klasik bir örnektir. Sürekli sayısal verileri (örneğin maaş miktarı) “Düşük”, “Orta” veya “Yüksek” gibi kategorilere bölme işlemine veri ayrıklaştırma denir.

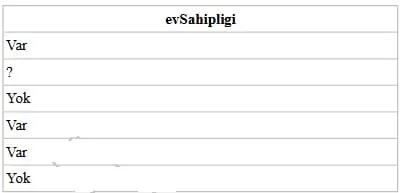
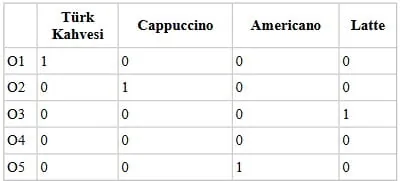
Veri hazırlama aşamasında eksik değerlerin giderilmesi hayati önem taşır. Kategorik bir nitelikteki eksik veri tamamlanırken genellikle sayıca en fazla olan kategorinin (mod) atanması en uygun yöntemdir. Ayrıca, kategorik verilerin algoritmalar tarafından işlenebilmesi için yapılan yapay (dummy) kodlama yönteminde, bir örneğin tüm görünür kategorilerdeki değeri “0” ise o örnek referans alınan son kategoriye aittir.

Makine Öğrenmesi Stratejileri ve Modeller

Makine öğrenmesi temel olarak üç ana strateji üzerine kuruludur: Danışmanlı (Supervised), Danışmansız (Unsupervised) ve Pekiştirmeli (Reinforcement) öğrenme. Danışmanlı öğrenmede bir hedef niteliğin (etiket) bulunması zorunluluktur; bu yöntemle sınıflandırma ve regresyon problemleri çözülür. Danışmansız öğrenme ise etiketsiz veriyle çalışır ve kümeleme, boyut azaltma, anormallik tespiti gibi görevleri kapsar. Sınıflandırma ise bu gruba girmez, bir danışmanlı öğrenme türüdür. Pekiştirmeli öğrenme ise ajan, çevre ve ödül-ceza prensipleriyle ilişkilidir.

Algoritmalar ve Uygulamalar

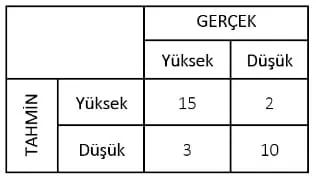
En yaygın danışmansız öğrenme algoritmalarından biri olan k-Ortalamalar (K-Means), verileri benzerliklerine göre gruplara ayırır. Örneğin, bir e-ticaret şirketinin müşterilerini alışveriş alışkanlıklarına göre kümelemesi bu algoritma için ideal bir görevdir. K-Means algoritmasında yeni bir veri noktası, merkezi kendine en yakın olan kümeye atanır. Algoritmanın başarısını ve tahmin performansını ölçmek için kontenjans tabloları (karmaşıklık matrisi) kullanılır. Bu tablolarda gerçek değer ile tahmin edilen değerin kesiştiği noktalar doğru tahmin sayılarını verir.

Günümüzde popülerleşen Üretken Yapay Zekâ (Generative AI) ise mevcut verilerden yeni metin, resim veya ses üretebilir; ancak bir veritabanı yönetim sistemi veri analizi yapsa da üretken yapay zekâ kategorisine girmez.

Python ile Veri Analizi ve Görselleştirme

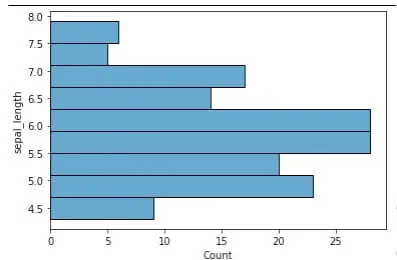
Veri biliminde veriyi anlamak için görselleştirme araçları ve kütüphaneler (Seaborn, Matplotlib, Pandas) kullanılır. Verilerin frekans dağılımını gösteren histogramlar, tek değişkenli analiz için uygundur ve verinin çarpıklığını görmemizi sağlar; ancak iki nitelik arasındaki ilişkiyi (korelasyonu) ortaya koymak için uygun değildir. Bir verideki aykırı değerleri (outliers) tespit etmek için en etkili araç kutu grafiğidir (Box Plot). Python kodlamasında yatay bir sütun grafiği çizmek için plt.barh() fonksiyonu kullanılırken, Seaborn’da yatay bir histogram için değişken “y” parametresine atanmalıdır (y=”değişken_adı”). Veri setinin istatistiksel özetini görmek için ise Pandas’ın .describe() fonksiyonuna başvurulur.

Makine Öğrenmesi 2024-2025 Vize Soruları (Bahar)

Makine Öğrenmesi 2024-2025 Vize Soruları (Bahar)
20 soru
Şıkka dokun, anında açıklamasını gör — ya da çalışma modunda tüm cevapları aç.
Soru 1
Aşağıdakilerden seçeneklerden hangisinde sıralı kategorik veriye örnek verilmiştir?
CDoğru cevap
Açıklama
Veri biliminde kategorik veriler “nominal” ve “ordinal” (sıralı) olarak ikiye ayrılır. Nominal verilerde (renkler veya meslekler gibi) öğeler arasında doğal bir hiyerarşi veya sıralama yoktur. Ancak ordinal verilerde, veriler arasında “küçüklükten büyüklüğe” veya “derecesine göre” anlamlı bir sıralama mevcuttur. “Küçük – orta – büyük” örneği, belirli bir ölçü veya yoğunluk sırasını takip ettiği için klasik bir sıralı kategorik veri örneğidir.
Soru 2
Aşağıdakilerden hangisi tipik bir makine öğrenmesi modeli bileşenlerden biri değildir?
CDoğru cevap
Açıklama
Bir makine öğrenmesi modeli temel olarak veriden öğrenen bir yapıdır. Bu yapının temel bileşenleri; girdi olarak kullanılan “nitelikler”, öğrenmenin gerçekleştiği “algoritma”, algoritmanın davranışını belirleyen “parametreler” ve öğrenme süreci için gereken “eğitim verisi”dir. Ancak veriyi görselleştirmek için yazılan Python kodları (grafik çizim kodları vb.), modelin kendi iç bileşeni veya çalışma mantığının bir parçası değil, veri bilimcinin veriyi anlamak için kullandığı harici bir araçtır.
Soru 3
Makine Öğrenmesi 2024-2025 Vize Soruları (Bahar) 3. SORU
Yukarıda verilen grafiğin çizilebilmesi için aşağıdaki seçeneklerden hangisi kullanılmalıdır?
ADoğru cevap
Açıklama
Görsel incelendiğinde, verilerin frekans dağılımını gösteren bir histogram (histplot) olduğu görülmektedir. Grafik dikey sütunlar yerine yatay çubuklar şeklinde çizilmiştir. Seaborn kütüphanesinde bir histogramı yatay eksende göstermek için, ilgili değişkeni “y” parametresine atamak gerekir. Bu nedenle doğru komut “sns.histplot” fonksiyonunda y eksenine değişkenin tanımlandığı seçenektir.
Soru 4
Günümüzdeki yapay zekâ çalışmaları üretken yapay zekâ (Generative AI) olarak adlandırılmaktadır.
Aşağıdakilerden hangisi üretken yapay zekâ sistemlerine örnek gösterilemez?
DDoğru cevap
Açıklama
Üretken yapay zekâ (Generative AI), mevcut verilerden öğrenerek tamamen yeni, özgün ve daha önce var olmayan içerikler (metin, resim, ses, video) üreten modellerdir. Grafik oluşturma, metin yazma veya müzik besteleme bu kapsama girer. Ancak bir veritabanı yönetim sistemi (DBMS), verileri saklamak, sorgulamak ve analiz etmek için kullanılan geleneksel bir yazılım aracıdır; kendi başına yeni bir içerik “üretme” (generative) yeteneğine sahip değildir.
Soru 5
Aşağıda verilen görev türlerinden hangisi danışmansız öğrenme kapsamına girmez?
BDoğru cevap
Açıklama
Makine öğrenmesinde “danışmanlı öğrenme” (supervised learning), etiketli veri (girdi-çıktı çiftleri) üzerinden yapılan öğrenmedir. “Sınıflandırma” görevinde, modelin bir veriyi belirli kategorilere (örneğin kedi mi köpek mi) ayırması beklenir ve bu eğitim sürecinde her verinin gerçek sınıf etiketi modele verilir. Kümeleme, boyut azaltma ve anormallik tespiti gibi görevler ise etiketsiz veriyle, verinin kendi iç yapısını keşfetmek için yapıldığından “danışmansız öğrenme” (unsupervised) kapsamındadır.
Soru 6
Histogramlarla ilgili aşağıda verilen bilgilerden hangisi yanlıştır?
CDoğru cevap
Açıklama
Histogram, “tek bir” değişkenin (tek değişkenli analiz) frekans dağılımını görselleştirmek için kullanılır. Bir niteliğin hangi değer aralıklarında yoğunlaştığını, çarpıklığını ve yayılımını gösterir. İki farklı nitelik arasındaki pozitif veya negatif korelasyonu/ilişkiyi görmek için histogram değil, genellikle “saçılım grafiği” (scatter plot) kullanılır.
Soru 7
Makine Öğrenmesi 2024-2025 Vize Soruları (Bahar) 7. SORU
Yukarıdaki tabloda kişilerin ev sahipliği durumunu gösteren evSahipligi niteliği verilmektedir. Bu nitelikteki eksik verinin (?) tamamlanmasına yönelik aşağıda verilen ifadelerden hangisi en uygundur?
CDoğru cevap
Açıklama
Kategorik (sayısal olmayan) verilerde eksik değerlerin tamamlanması için kullanılan en yaygın ve basit yöntem “mod” (tepe değer) atamasıdır. Yani o nitelikte en çok tekrar eden kategori hangisiyse, eksik olan yere o değer atanır. Sayısal verilerde ortalama veya medyan kullanılırken, ev sahipliği (Var/Yok) gibi kategorik durumlarda çoğunluğun sahip olduğu değerin atanması istatistiksel bir tahmindir.
Soru 8
Aşağıdaki seçeneklerden hangisindeki Python fonksiyonu, bir sütun grafiğinin yatay biçimde oluşturulmasını sağlar?
DDoğru cevap
Açıklama
Python’un temel görselleştirme kütüphanesi olan Matplotlib içerisinde “bar” fonksiyonu dikey sütun grafikleri çizerken, fonksiyonun sonuna eklenen “h” harfi (horizontal – yatay) ile çağrılan “barh()” fonksiyonu çubukların yatay olarak konumlanmasını sağlar.
Soru 9
Aşağıda verilen grafik türlerinden hangisinde bir niteliğe ait aykırı değerler görülebilir?
EDoğru cevap
Açıklama
Kutu grafiği (Box Plot), bir verinin dağılımını çeyreklikler üzerinden gösterir. Bu grafikte kutunun dışına taşan ve genellikle nokta veya yıldız sembolüyle işaretlenen değerler “aykırı değerler” (outliers) olarak tanımlanır. Bu grafik, verideki normalin dışındaki sapan noktaları tespit etmek için en etkili görsel araçtır.
Soru 10
Makine Öğrenmesi 2024-2025 Vize Soruları (Bahar) 10. SORU
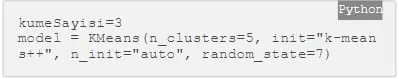
Yukarıda verilen Python kodlarını çalıştıran bir araştırmacı hangi algoritmayı ve bu algoritma için aşağıdaki hangi parametreyi kullanıyor olabilir?
DDoğru cevap
Açıklama
Kod içerisinde geçen “KMeans” ifadesi, bu algoritmanın k-Ortalamalar (K-Means) kümeleme algoritması olduğunu açıkça göstermektedir. Fonksiyonun içindeki “n_clusters=5” parametresi ise verinin kaç adet gruba (kümeye) ayrılacağını belirler. Dolayısıyla araştırmacı, k-Ortalamalar algoritmasını 5 küme hedefiyle kullanmaktadır.
Soru 11
Aşağıdakilerden hangisi makine öğrenmesi stratejilerinden biridir?
DDoğru cevap
Açıklama
Makine öğrenmesi literatüründe öğrenme stratejileri üç temel ana başlığa ayrılır: Danışmanlı öğrenme (Supervised), Danışmansız öğrenme (Unsupervised) ve Pekiştirmeli öğrenme (Reinforcement). Şıklarda yer alan diğer terimler (ezberlemeli, rastgele vb.) standart makine öğrenmesi strateji sınıflandırmaları arasında yer almaz.
Soru 12
Aşağıdaki görevlerin hangisini k-Ortalamalar Algoritmasını kullanarak gerçekleştirmek daha uygundur?
ADoğru cevap
Açıklama
k-Ortalamalar (K-Means) bir “kümeleme” algoritmasıdır. Kümeleme, verilerin arasındaki benzerlikleri bularak onları gruplara ayırma işlemidir. Diğer seçenekler (B, C, D, E) hedef bir değeri tahmin etmeye yönelik “sınıflandırma” veya “regresyon” (danışmanlı öğrenme) görevleridir. Müşterileri benzer davranışlarına göre gruplandırmak tam bir kümeleme görevidir.
Soru 13
Makine Öğrenmesi 2024-2025 Vize Soruları (Bahar) 13. SORU
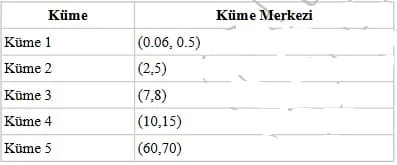
kOrtalamalar algoritması kullanılarak gerçekleştirilen kümeleme sonucunda elde edilen kümeler ve küme merkezleri yukarıdaki tabloda verilmiştir. Buna göre; örnek veri (3,6) hangi kümeye benzerlik gösterir ve atanır?
BDoğru cevap
Açıklama
K-Means algoritmasında bir veri noktası, “merkezi kendine en yakın” olan kümeye atanır. Verilen (3, 6) noktası ile tablodaki merkezler arasındaki Öklid mesafesi hesaplanırsa; Küme 2’nin merkezi olan (2, 5) noktasına olan uzaklığın diğer merkezlere (örneğin Küme 1: 0.06, 0.5 veya Küme 3: 7, 8) oranla çok daha az olduğu görülür. En yakın merkez Küme 2 olduğundan veri bu kümeye dahil edilir.
Soru 14
Makine Öğrenmesi 2024-2025 Vize Soruları (Bahar) 14. SORU
Yukarıda verilen kontenjans tablosuna göre doğru tahmin edilen Düşük risk grubundaki müşterilerin sayısı aşağıdaki seçeneklerden hangisinde doğru biçimde verilmiştir?
ADoğru cevap
Açıklama
Kontenjans tablosunda (Karmaşıklık Matrisi), “Gerçek” değer ile “Tahmin” değerinin kesiştiği hücreler doğru tahminleri gösterir. Tabloya göre; Gerçekte “Düşük” olan ve model tarafından da “Düşük” olarak tahmin edilen değerlerin kesişim noktasındaki sayı 10’dur. (Gerçek Yüksek – Tahmin Yüksek kesişimi ise 15’tir).
Soru 15
cagrilar: Bir bankanın çağrı merkezine gelen aramaların sayısı (500, 750, 1000, …).
cagrilar niteliğinin veri tipi için aşağıdaki seçeneklerden hangisi en uygundur?
EDoğru cevap
Açıklama
Sayısal veriler “sürekli” ve “ayrık” olarak ikiye ayrılır. Sürekli veriler (boy, kilo, sıcaklık vb.) bir aralıktaki her türlü ondalıklı değeri alabilir. Ayrık veriler ise tam sayılarla ifade edilen ve genellikle “sayma” yoluyla elde edilen değerlerdir. Çağrı sayısı (yarı çağrı olamayacağı için) 1, 2, 500 gibi net tam sayılarla ifade edildiğinden “ayrık” veri tipine girer.
Soru 16
Bir Pandas DataFrame olarak verilen musteri adlı veri setinin özet bilgisini görüntülemek için aşağıdaki seçeneklerden hangisi kullanılabilir?
BDoğru cevap
Açıklama
Pandas kütüphanesinde, bir veri setindeki sayısal kolonların ortalama, standart sapma, min, max ve çeyreklik değerlerini tek bir tabloda özetleyen temel fonksiyon “.describe()” fonksiyonudur. Bu fonksiyon veri setine hızlıca bir bakış atmayı sağlar.
Soru 17
Makine Öğrenmesi 2024-2025 Vize Soruları (Bahar) 17. SORU
Tabloda kahve örneklerinin (O1, O2, O3, O4 ve O5) kahveTuru niteliği yapay (dummy) kodlama kullanılarak verilmiştir. kahveTuru niteliğinde, Americano, Cappuccino, Latte, Mocha ve Türk Kahvesi çeşitleri bulunmakta olup, örnekler verilen kahve türlerinden yalnızca birine aittir.
Yukarıda verilenlere göre, Örnek 4’ün (O4) kahveTuru aşağıdakilerden hangisidir?
ADoğru cevap
Açıklama
Yapay (Dummy) kodlamada, her kategori için ayrı bir kolon oluşturulur. Eğer bir örnekte tüm görünür kolonlar (Türk Kahvesi, Cappuccino, Americano, Latte) “0” ise, o örnek tablonun dışında kalan (referans alınan veya eksik gösterilen) son kategoriye aittir. Soruda 5 çeşit kahve olduğu (Mocha dahil) ancak tabloda 4 kolon olduğu belirtilmiştir. Örnek 4 için tablodaki 4 tür de “0” olduğuna göre, Örnek 4 tablonun ismen yer almayan 5. türü olan Mocha’dır.
Soru 18
Makine öğrenmesi stratejileri ile ilgili aşağıdakilerden hangisi yanlıştır?
BDoğru cevap
Açıklama
Danışmanlı öğrenmenin (Supervised Learning) en temel kuralı, eğitim verisinde bir “hedef niteliğin” (target/label) bulunmasıdır. Model, girdilerle bu hedef çıktılar arasındaki ilişkiyi öğrenir. Hedef niteliğin olmadığı öğrenme türü “danışmansız öğrenme”dir. Dolayısıyla B şıkkı yanlıştır.
Soru 19
Aşağıdaki seçeneklerden hangisi makine öğrenmesinin temel unsurları arasında yer almaz?
EDoğru cevap
Açıklama
Tom Mitchell’in klasik tanımına göre makine öğrenmesi; bir “görev” (T) üzerinde, bir “performans” (P) ölçütü ile “deneyimden” (E) öğrenen bir sistemdir. “Algoritma” bu öğrenmeyi sağlayan matematiksel yapıdır. Ancak programlama dili (Python, R, Java vb.) sadece bu işi uygulamak için kullanılan bir araçtır; makine öğrenmesinin teorik ve bilimsel tanımının temel bir unsuru değildir.
Soru 20
Makine Öğrenmesi 2024-2025 Vize Soruları (Bahar) 20. SORU
Yukarıda verilen Maaş niteliğinin kategorik hale getirilebilmesi için aşağıda verilen yöntemlerden hangisi kullanılabilir?
EDoğru cevap
Açıklama
Maaş gibi sürekli sayısal verileri “Düşük”, “Orta”, “Yüksek” gibi gruplara/kategorilere ayırmak işlemine “veri ayrıklaştırma” veya “binning” denir. Bu işlem, sayısal değerleri belirli aralıklara bölerek onları kategorik bir forma sokar. Normalizasyon ölçeklendirme yapar, temizleme hataları giderir; kategorik hale getiren asıl işlem ise ayrıklaştırmadır.