Üç Ders 2024 20 soru

Makine Öğrenmesi 2024 Üç Ders

Kaynak: https://lolonolo.com/2025/09/05/makine-ogrenmesi-2024-uc-ders-sinav-sorulari/

📖 Konu özeti (sınav öncesi tekrar)

Makine Öğrenmesi 2024 Üç Ders Sınav Soruları

Makine Öğrenmesi 2024 Üç Ders Sınav Soruları

Giriş

Makine öğrenmesi, bilgisayarların verilerden öğrenerek görevleri yerine getirmesini sağlayan bir yapay zekâ dalıdır. Bu alanın temel unsurları; bir “Görev”, görevi öğrenmek için kullanılan “Deneyim (Veri)” ve görevin ne kadar iyi yapıldığını ölçen bir “Performans” metriğidir. Kullanılan programlama dili ise bir uygulama aracıdır, temel bir unsur değildir. Bu makalede, makine öğrenmesi sürecinin temel adımları, popüler algoritmalar ve bu algoritmaların performansını değerlendirme yöntemleri incelenecektir.

Veri: Makine Öğrenmesinin Yakıtı

Her makine öğrenmesi projesi veri ile başlar. Veriler, “küçük – orta – büyük” gibi doğal bir sıralamaya sahip olan “sıralı kategorik veri” gibi farklı türlerde olabilir. Modellerin daha iyi performans göstermesi için veri ön işleme adımı kritik öneme sahiptir. Veri setinde diğer gözlemlerden önemli ölçüde uzak olan “aykırı değerler” tespit edilip uygun şekilde ele alınmalıdır. Maaş gibi sürekli bir sayısal değişkeni, “düşük”, “orta”, “yüksek” gibi kategorilere ayırma işlemine “veri ayrıklaştırma” denir. Kategorik değişkenleri sayısal formata dönüştürmek için ise “yapay (dummy) kodlama” gibi teknikler kullanılır. Veriyi anlamanın en iyi yollarından biri görselleştirmedir; Python’da “Matplotlib” ve “Seaborn” bu amaçla kullanılan başlıca kütüphanelerdir. Bir değişkenin dağılımını görmek için “histogram” kullanılırken, iki değişken arasındaki ilişkiyi görmek için saçılım grafikleri tercih edilir.

Makine Öğrenmesi Algoritmaları

Veri hazırlandıktan sonra, probleme uygun bir algoritma seçilir. Makine öğrenmesi stratejileri genel olarak “Danışmanlı (Gözetimli)”, Danışmansız (Gözetimsiz) ve Pekiştirmeli Öğrenme olarak üçe ayrılır.

Sınıflandırma: “Bana arkadaşını söyle, sana kim olduğunu söyleyeyim” atasözünün mantığıyla çalışan “k-En Yakın Komşu (k-NN)” algoritması, bir veri noktasını en yakın komşularına göre sınıflandırır. “Naive Bayes” algoritmasının sürekli verilerle çalışan versiyonu ise, niteliklerin “Normal (Gauss) dağılımına” uyduğu varsayımını yapar. “Karar Ağaçları” ise veriyi kurallara göre bölen popüler bir yöntemdir; ID3, C4.5 ve CART bu alandaki bilinen algoritmalardır.

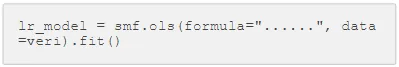
Regresyon: Bir veya daha fazla bağımsız değişkenin, sonuç durumundaki “bağımlı değişken” üzerindeki etkisini modeller. Örneğin, ev fiyatını (fiyat) evin büyüklüğü (buyukluk) ve bulunduğu bölgeye (bolge) göre tahmin etmek için `fiyat ~ buyukluk + bolge` şeklinde bir formül kullanılır.

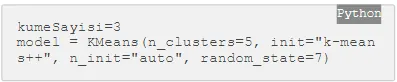
Kümeleme: “k-Ortalamalar (k-Means)” algoritması, etiketlenmemiş verileri belirli sayıda kümeye ayırmak için kullanılır. `KMeans(n_clusters=5)` gibi bir kod, bu algoritmanın 5 küme ile çalıştırıldığını gösterir.

Yapay Sinir Ağları: İnsan beyninden esinlenen bu modellerde, bir nöronun “net girdisi”, her bir girdinin kendi ağırlığıyla çarpılıp toplanmasıyla (ağırlıklı toplam) hesaplanır.

Model Kurulumu ve Değerlendirme

Bir makine öğrenmesi modeli; eğitim verisi, nitelikler, algoritma ve parametreler gibi temel bileşenlerden oluşur. Modelin kurulmasından sonra performansı titizlikle değerlendirilmelidir. Çoklu doğrusal regresyon modelinde, bir niteliğin anlamlı olup olmadığına genellikle “p-değeri 0.05’ten küçükse” karar verilir. Modelin genel açıklama gücü ise “belirginlik katsayısı (R²)” ile ölçülür; 1’e en yakın değer en iyi modeli gösterir. Sınıflandırma modellerinde ise doğruluk (accuracy) ve “hata oranı” (error rate = 1 – accuracy) gibi metrikler kullanılır. Kümeleme analizinde ise en uygun küme sayısını belirlemek için “Silhouette katsayısı” gibi metriklerden faydalanılır; en yüksek katsayı en iyi sonucu gösterir. Modelin performansını daha güvenilir bir şekilde ölçmek için ise “çapraz geçerleme” (cross-validation) tekniği kullanılır ve nihai performans, her katlamada elde edilen sonuçların “ortalaması” alınarak bulunur.

Sonuç

Makine öğrenmesi, verilerden desenler öğrenerek akıllı sistemler oluşturma sürecidir. Bu sürecin temellerinde, Alan Turing tarafından geliştirilen ve bir makinenin zekasını test etmek için bir “insan denek” gerektiren “Turing Testi” gibi felsefi fikirler yatar. Günümüzde ise makine öğrenmesi, veri ön işlemeden algoritma seçimine ve titiz model değerlendirmesine kadar uzanan sistematik bir mühendislik disiplini haline gelmiştir.

Makine Öğrenmesi 2024 Üç Ders Sınav Soruları

Makine Öğrenmesi 2024 Üç Ders Sınav Soruları
20 soru
Şıkka dokun, anında açıklamasını gör — ya da çalışma modunda tüm cevapları aç.
Soru 1
Aşağıdaki seçeneklerden hangisinde sıralı kategorik veriye örnek verilmiştir?
CDoğru cevap
Açıklama
Sıralı (ordinal) kategorik veri, kategorileri arasında doğal bir sıralama veya hiyerarşi olan veridir. “Küçük, orta, büyük” seçenekleri arasında belirgin bir sıralama ilişkisi vardır.
Soru 2
Makine Öğrenmesi 2024 Üç Ders Sınav Soruları 2. SORU-min
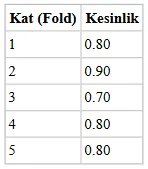
Naive Bayes Algoritması modelinin 5kat çapraz geçerleme sonucunda elde edilen kesinlik değerleri yukarıdaki tabloda verilmiştir. Buna göre modelin nihai performansı aşağıdaki seçeneklerden hangisinde doğru olarak verilmiştir?
BDoğru cevap
Açıklama
Çapraz geçerleme sonucunda modelin nihai performansı, her katlamada (fold) elde edilen performans metriklerinin ortalaması alınarak hesaplanır. Tablodaki değerlerin ortalaması: (0.80 + 0.90 + 0.70 + 0.80 + 0.80) / 5 = 4.0 / 5 = 0.80.
Soru 3
Turing Testi ile ilgili aşağıdakilerden hangisi yanlıştır?
DDoğru cevap
Açıklama
Turing Testi’nin temel mantığı, bir insanın, karşısındaki varlığın insan mı yoksa makine mi olduğunu anlayamamasıdır. Bu nedenle testin olmazsa olmaz bileşeni, değerlendirmeyi yapan bir insan denektir.
Soru 4
Histogramlarla ilgili aşağıda verilen bilgilerden hangisi yanlıştır?
ADoğru cevap
Açıklama
Bu ifade yanlıştır. Histogram, tek bir sürekli değişkenin dağılımını (frekansını) gösterir. İki nitelik (değişken) arasındaki ilişkiyi göstermek için saçılım grafiği (scatter plot) kullanılır.
Soru 5
Makine Öğrenmesi 2024 Üç Ders Sınav Soruları 5. SORU-min
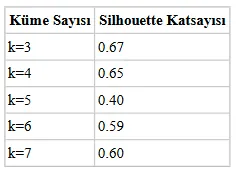
k­Ortalamalar algoritması ile farklı küme sayıları (k=3,4,5,6,7) kullanılarak 5 ayrı kümeleme analizi gerçekleştirilmiştir. Analizler sonucunda elde edilen Silhouette katsayısı değerlerine göre aşağıdaki hangi küme sayısını seçmek en uygundur?
EDoğru cevap
Açıklama
Silhouette katsayısı, kümeleme analizinin kalitesini ölçen bir metriktir ve -1 ile +1 arasında değer alır. 1’e en yakın olan değer en iyi kümeleme sonucunu gösterir. Tablodaki en yüksek Silhouette katsayısı 0.67 ile k=3’e aittir.
Soru 6
Çoklu doğrusal regresyon analizinde niteliklerin (beta) katsayılarına bakılarak model için anlamlı olup olmadıklarına aşağıdakilerden hangisi kullanılarak karar verilir?
BDoğru cevap
Açıklama
İstatistiksel modellemede, bir değişkenin (nitelik) sonuç üzerinde anlamlı bir etkisinin olup olmadığına, o değişkene ait p-değerine bakılarak karar verilir. Genel kabul gören anlamlılık düzeyi (alfa) 0.05’tir ve p-değerinin bu seviyeden küçük olması, değişkenin anlamlı olduğunu gösterir.
Soru 7
Aşağıdaki seçeneklerde verilen Python kütüphanelerinden hangileri veri görselleştirme üzerine özelleşmiştir?
EDoğru cevap
Açıklama
Matplotlib, Python’da veri görselleştirme için temel kütüphanedir. Seaborn ise Matplotlib üzerine inşa edilmiş, istatistiksel grafikleri daha kolay ve estetik bir şekilde çizmek için kullanılan bir diğer popüler görselleştirme kütüphanesidir.
Soru 8
Makine Öğrenmesi 2024 Üç Ders Sınav Soruları 8. SORU-min
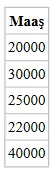
Yukarıda verilen Maaş niteliğinin kategorik hale getirilebilmesi için aşağıda verilen yöntemlerden hangisi kullanılabilir?
CDoğru cevap
Açıklama
Maaş gibi sürekli bir sayısal değişkeni, “düşük”, “orta”, “yüksek” gibi kategorilere ayırma işlemine veri ön işlemede “veri ayrıklaştırma” (data discretization) veya “gruplama” (binning) denir.
Soru 9
Makine Öğrenmesi 2024 Üç Ders Sınav Soruları 9. SORU-min
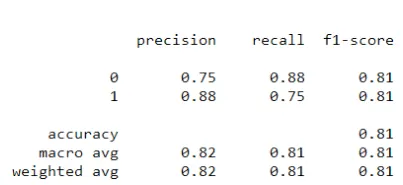
k­En Yakın Komşu Algoritmasının performans değerlendirmesi sonucu elde edilen rapordan bir kesit yukarıda verilmiştir. Buna göre k­En Yakın Komşu modelinin hata oranı (error rate) aşağıdakilerden hangisidir?
ADoğru cevap
Açıklama
Hata Oranı (Error Rate), 1 – Doğruluk Oranı (Accuracy) formülüyle hesaplanır. Sınıflandırma raporlarında verilen doğruluk değeri genellikle 0 ile 1 arasındadır. Seçeneklere bakıldığında, 0.81’in doğruluk oranı olması muhtemeldir. Bu durumda Hata Oranı = 1 – 0.81 = 0.19 olur.
Soru 10
Makine Öğrenmesi 2024 Üç Ders Sınav Soruları 10. SORU-min
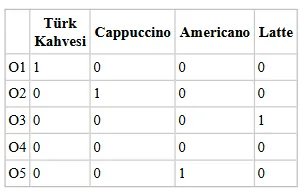
Tabloda kahve örneklerinin (O1, O2, O3, O4 ve O5) kahveTuru niteliği yapay (dummy) kodlama kullanılarak verilmiştir. kahveTuru niteliğinde, Americano, Cappuccino, Latte, Mocha ve Türk Kahvesi çeşitleri bulunmakta olup, örnekler verilen kahve türlerinden yalnızca birine aittir.
Yukarıda verilenlere göre, Örnek 4’ün (O4) kahveTuru aşağıdakilerden hangisidir?
ADoğru cevap
Açıklama
Yapay (dummy) kodlamada, n adet kategori varsa, n-1 adet yeni sütun oluşturulur. Bütün yeni sütunların “0” değerini aldığı gözlem, referans (temel) kategoriye aittir. Tabloda Türk Kahvesi, Cappuccino, Americano ve Latte için sütunlar vardır. O4 örneği hepsinde “0” aldığı için, bu beşinci kahve türü olan Mocha’yı temsil eder.
Soru 11
Naive Bayes sınıflandırıcı ile analizler gerçekleştirilirken niteliklerin veri tipinin sürekli olması durumunda sürekli değerler ile ilgili genel kabul …… uygun dağıldığıdır.
Yukarıda verilen boşluğa aşağıdakilerden hangisi getirilebilri?
BDoğru cevap
Açıklama
Naive Bayes algoritmasının sürekli verilerle çalışan versiyonu olan “Gaussian Naive Bayes”, her bir sınıfa ait sürekli niteliklerin olasılıklarının Normal (Gauss) dağılımına uyduğu varsayımını yapar.
Soru 12
Aşağıdaki seçeneklerden hangisi makine öğrenmesinin temel unsurları arasında yer almaz?
BDoğru cevap
Açıklama
Tom Mitchell’ın tanımına göre makine öğrenmesinin üç temel unsuru vardır: Görev (Task), Deneyim (Experience – Veri) ve Performans Ölçütü (Performance). Algoritma ise bu süreci yürüten yöntemdir. Kullanılan programlama dili (Python, R vb.) ise bir uygulama aracıdır, temel bir unsur değildir.
Soru 13
Makine Öğrenmesi 2024 Üç Ders Sınav Soruları 13. SORU-min
Yukarıda verilen Python kodlarını çalıştıran bir araştırmacı hangi algoritmayı ve bu algoritma için aşağıdaki hangi parametreyi kullanıyor olabilir?
CDoğru cevap
Açıklama
Verilen kod `model = KMeans(n_clusters=5, …)` şeklindedir. `KMeans`, k-Ortalamalar (k-Means) algoritmasını ifade eder. `n_clusters=5` parametresi ise küme sayısının 5 olarak belirlendiğini gösterir.
Soru 14
𝑥1 = 100, 𝑥2 = 40𝑤1 = 0 . 1, 𝑤2 = 0 . 5
Bir nöronun girdileri (𝑥1, 𝑥2) ve ağırlıkları (𝑤1, 𝑤2) yukarıda verilmiştir. Bu nöronun net girdisi ağırlıklı toplam (weighted sum) fonksiyonu kullanılarak hesaplanırsa; nöronun net girdisi aşağıdaki seçeneklerden hangisi olur?
CDoğru cevap
Açıklama
Ağırlıklı toplam (weighted sum) fonksiyonu, her girdinin kendi ağırlığıyla çarpılıp sonuçların toplanmasıyla hesaplanır. Net Girdi = (x1 * w1) + (x2 * w2) = (100 * 0.1) + (40 * 0.5) = 10 + 20 = 30.
Soru 15
Aşağıdakilerden hangisi makine öğrenmesi stratejilerinden biridir?
DDoğru cevap
Açıklama
Makine öğrenmesinin üç ana stratejisi (paradigması) vardır: Gözetimli/Danışmanlı Öğrenme (Supervised Learning), Gözetimsiz/Danışmansız Öğrenme (Unsupervised Learning) ve Pekiştirmeli Öğrenme (Reinforcement Learning).
Soru 16
Aşağıdakilerden hangisi bir karar ağacı algoritması değildir?
EDoğru cevap
Açıklama
ID3, C4.5, C5.0 ve CART, karar ağacı oluşturmak için geliştirilmiş, literatürde iyi bilinen algoritmalardır. ID8.15 ise böyle bir algoritma ismi değildir.
Soru 17
“Bana arkadaşını söyle, sana kim olduğunu söyleyeyim” atasözü ile özdeşleşen makine öğrenmesi algoritması aşağıdakilerden hangisidir?
DDoğru cevap
Açıklama
Bu atasözü, bir kişinin en yakınındaki kişilere benzediği fikrini yansıtır. k-En Yakın Komşu (k-NN) algoritması da tam olarak bu mantıkla çalışır: Bir veri noktasını, ona en yakın ‘k’ adet komşusunun çoğunlukta olduğu sınıfa atar.
Soru 18
Makine Öğrenmesi 2024 Üç Ders Sınav Soruları 18. SORU-min
Bir emlak şirketi, ev fiyatlarını tahmin etmek için çoklu doğrusal regresyon kullanmak istemektedir. Bu analizde, evin büyüklüğü (buyukluk) ve bulunduğu bölge (bolge) gibi değişkenlerin ev fiyatını (fiyat) nasıl etkilediğini inceleyeceklerdir. Buna göre; yukarıda …… ile verilen boşluğa aşağıdaki seçeneklerden hangisi getirilmelidir?
EDoğru cevap
Açıklama
R ve Python (statsmodels kütüphanesi) gibi istatistiksel programlama dillerinde regresyon modelleri formül notasyonu ile ifade edilir. Bu notasyonda bağımlı değişken sola, “~” işareti ve ardından “+” ile ayrılmış bağımsız değişkenler sağa yazılır. “fiyat” tahmin edilmek istendiği için formül `fiyat ~ buyukluk + bolge` şeklinde olmalıdır.
Soru 19
Aşağıdakilerden hangisi tipik bir makine öğrenmesi modeli bileşenlerden biri değildir?
DDoğru cevap
Açıklama
Bir makine öğrenmesi modelinin temel bileşenleri; modelin öğrendiği veri (eğitim verisi), veriden öğrendiği özellikler (nitelikler), öğrenme sürecini yöneten yöntem (algoritma) ve bu algoritmanın ayarlarıdır (parametreler). Veriyi görselleştirmek için yazılan kod, modelin kendisinin bir parçası değil, veri analizi veya sonuç sunumu aşamasının bir aracıdır.
Soru 20
Bir veri setinde diğer gözlemlerden önemli ölçüde uzak olan gözlemlere verilen ad aşağıdakilerden hangisidir?
ADoğru cevap
Açıklama
Bu, istatistik ve veri biliminde “aykırı değer” (outlier) olarak adlandırılan durumun tanımıdır. Aykırı değerler, genel veri dağılımının oldukça dışında kalan ve model performansını olumsuz etkileyebilen gözlemlerdir.