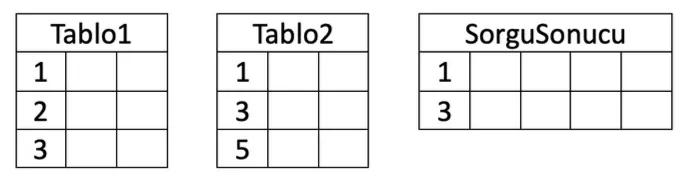
Yukarıdaki SQL sorgusunun açıklaması hangi şıkta doğru verilmiştir?
CDoğru cevap
Açıklama
Sorgu, 18 yaşından büyük ve istihdamı “EVET” olan ya da pasaportu “GEÇERLİ” kullanıcıları getirir.
Kaynak: https://lolonolo.com/2025/03/10/veri-tabani-yonetimi-2023-2024-final-sorulari/
Veri Tabanı Yönetimi 2023-2024 Final Soruları
Veri tabanı, belirli bir amaca hizmet eden veya belirli bir işlemi kolaylaştıran verilerin sistematik şekilde depolandığı yapıdır. Gündelik hayatta internet sitelerinden kurumsal uygulamalara, akıllı cihazlardan büyük veri (big data) analitiğine kadar pek çok alanda veri tabanı yönetimi gereklidir.
Bu alandaki ilk çalışmalar, verilerin manyetik şeritler ve kartlarla işlenmesine dayanır. Zaman içinde veri tabanı yönetim sistemleri gelişerek ilişkisel (relational), nesne yönelimli (object-oriented) ve NoSQL gibi farklı modeller ortaya çıkmıştır. Günümüzde işletmeler, yüksek hacimli verileri kolayca yönetebilmek ve ihtiyaç duyduklarında hızlı erişim sağlayabilmek için gelişmiş veri tabanı yönetim sistemlerine başvururlar.
İlişkisel model, tablolar (relation) ve bu tablolardaki satırlar (kayıt) ile sütunlardan (nitelik/alan) oluşan, verilerin mantıksal olarak yapılandırıldığı bir modeldir. Her tablo, kendine özgü birincil anahtar (primary key) alanına sahiptir; bu da tablo satırlarını benzersiz kılar. Başka bir tabloda, bu birincil anahtar bir “yabancı anahtar” (foreign key) olarak kullanılabilir. Böylelikle tablolar arasında mantıksal ilişkiler kurulur.
İlişkisel veri tabanlarının avantajları arasında, tutarlılık (consistency), veri bütünlüğü (data integrity) ve esnek sorgulama yetenekleri ön plana çıkar. Bu modele uygun olarak geliştirilmiş SQL dili (Structured Query Language), verilerin sorgulanması, güncellenmesi, silinmesi ve tanımlanmasında standart kabul edilir.
SELECT sorgusu, tablo veya tablolardan veri çekmek için kullanılır. Örneğin:
SELECT * FROM Kullanici WHERE yas > 18;
Bu sorgu, 18 yaş üstü tüm kullanıcı kayıtlarını listelemeye yarar.
INSERT, tablolara yeni kayıt eklemek; UPDATE, mevcut kayıtları güncellemek; DELETE ise istenilen kayıtları veritabanından silmek için kullanılır. Bu dörtlü komut seti (C-R-U-D: Create, Read, Update, Delete) veri tabanı yönetiminin temelini oluşturur.
Gerçek hayatta veriler çoğu zaman birden fazla tabloda saklanır. Örneğin, kullanıcı bilgileri “Kullanici” tablosunda, sipariş bilgileri “Siparis” tablosunda bulunabilir. Bu iki tablo arasında ortak bir anahtar yardımıyla (örneğin, “kullanici_id” alanı) ilişki kurulur. INNER JOIN, LEFT JOIN, RIGHT JOIN gibi yöntemlerle bu tablolar sorgulamada birleştirilir ve ilişkili veriler tek bir set halinde elde edilir.
GROUP BY ifadesi, satırların ortak bir değere göre gruplandırılarak özet bilgiler çıkarmaya olanak tanır. Örneğin unvan bazında en düşük ve en yüksek maaş sorgusu için:
SELECT unvan, MIN(maas), MAX(maas) FROM Calisan GROUP BY unvan;
Bu sorgu, her bir unvan için maaş aralığını gösterir.
Bir veri tabanı oluşturma sürecinin en kritik aşaması, veri tabanı tasarımıdır. İyi tasarlanmış bir veri tabanı, performans ve veri bütünlüğü açısından büyük fayda sağlar. Tasarım sürecinde “normalizasyon” ilkeleri uygulanır:
Normalizasyon, verilerin tekrarını (redundancy) azaltır, tutarlılığı artırır. Bazı projelerde performans gereksinimleri sebebiyle normalizasyonun seviyesini azaltmak veya veriyi belirli tablo/parçalar halinde (denormalization) saklamak da söz konusu olabilir.
Proje ve kurum ihtiyaçlarına uygun bir VTYS (Veri Tabanı Yönetim Sistemi) seçimi yapılması gerekir. Bu seçimde şu kriterler dikkate alınır:
Kurumun ihtiyaçları, verinin hacmi ve yapısı (örneğin, yapılandırılmış veya belge tabanlı), kullanım senaryoları (online işlem, analitik işlem vs.) en doğru VTYS seçimine yol gösterir.
Veri tabanı yönetiminde yedekleme (backup) ve kurtarma (recovery) planları kritik rol oynar. Olası bir donanım arızası, sistem hatası veya doğal afet durumunda, verilerin kaybolmaması için düzenli yedekler alınmalı ve bu yedeklerin geri yüklenebilirliği (restore) test edilmelidir.
Kullanıcı ve sistem yetkilendirmeleri, veri tabanına erişimi doğru biçimde kısıtlayarak güvenlik sağlar. Belirli roller (örneğin, “yönetici”, “okuyucu”, “yazıcı”) ile hangi kullanıcıların hangi tablo veya sütunlara erişebileceği netleştirilir. Böylelikle hassas veriler, sadece yetkili kişilerin kullanımına sunulur.
Yüksek trafik veya veri hacmi söz konusu olduğunda, veri tabanı sistemini büyütmek (scaling) gerekebilir. Temel ölçeklendirme türleri şöyledir:
Hangisinin kullanılacağı, projeye ayrılan bütçe ve uygulamanın doğasıyla doğrudan ilişkilidir. Örneğin, çok fazla veri girilen ve sorgulanan bir e-ticaret sitesi çoğu zaman yatay ölçeklendirme yöntemlerini kullanır.
Klasik ilişkisel veri tabanlarının yanı sıra, belge tabanlı (MongoDB), anahtar-değer (Redis), sütun odaklı (Cassandra) gibi çeşitli NoSQL çözümleri vardır. Bu sistemler özellikle büyük ölçekli verilerle çalışırken esneklik ve yüksek performans sunar.
Redis gibi in-memory veri tabanları ise veriyi öncelikli olarak bellekte tutar ve bu sayede çok hızlı erişim sağlar. Genellikle oturum yönetimi, önbellekleme (caching) gibi performansın kritik olduğu noktalarda tercih edilir.
Veri Tabanı Yönetimi 2023-2024 Final Sınavı, SQL sorgularından prosedür yazmaya, veri tabanı tasarım ilkelerinden ölçeklendirme yöntemlerine kadar geniş bir içerik sunar. Bu bilgilerin tamamı, sektördeki bir veri tabanı uzmanının veya yazılım geliştiricinin başarılı projeler üretmesi için gereklidir.
Veri tabanı yönetimi sadece teknik komutların öğrenilmesi değil, aynı zamanda verinin bütünlüğünü korumak, kullanıcı yetkileri ve güvenlik gibi yönetimsel boyutları da kapsar. Bu yaklaşım, uzun vadede sistemin sürdürülebilirliği ve kurumsal başarısı açısından hayati önem taşır.